😄
0 内核利用Github awesome-windows-kernel-security-development 。
1 VS内联汇编 在编译 32 位程序的时候,直接 __asm 内联汇编即可使用,但是当目标平台为 x64 时,微软不再允许直接内联汇编了,可通过在 64 位程序中内联汇编代码。
IDE:VS 2019
OS:Windows 10 21H2(19044.2130)
创建控制台项目。
源文件 右键—添加 —新建项 —C++文件 ,命名为 First_Inline_Asm.asm。
在源文件 First_Inline_Asm.asm 右键—属性 —项类型 —自定义生成工具 —应用(然后属性上就多出来了“自定义生成工具”)。
在上一步骤基础上,自定义常规工具 —常规 —命令行:ml64 /c %(filename).asm; 输出:%(filename).obj;%(Outputs)。
在上一步骤基础上,平台:活动x64。
汇编文件的配置属性 —从中生成排除:否 。
.asm 里面函数的写法:
1
2
3
4
5
6
7
8
9
10
11
; 指定代码编译(可省略)bit 16 , bit 32 , bit 64 .CODE GetPebLdr PROC mov rax, gs:[60 h]; add rax, 18 h; mov rax, [rax]; ret; GetPebLdr ENDP END
在主文件中:
1 extern "C" ULONGLONG _fastcall GetPebLdr (void ) ;
注意这种内联汇编源操作数如果是十六进制数 ,写法如下:
1 2 3 4 5 6 7 8 mov rax, 0xFFEEDDCC01234567 ; mov rax, FFEEDDCC01234567h; mov rax, 0F FEEDDCC01234567h;
完整 Demo:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 .CODE GetPebLdr PROC mov rax, gs:[60 h]; add rax, 18 h; mov rax, [rax]; ret; GetPebLdr ENDP END #include <iostream> #include <windows.h> extern "C" PVOID64 _fastcall GetPebLdr (void ) ;int main () PVOID64 pRet = GetPebLdr(); printf ("%p\n" , pRet); }
参考:使用VS2019写64位内联汇编 。
2 寄存器 2.1 通用寄存器(GPRs) x64 下指针和地址都是 8 字节(64位)。
x64 增加了8个通用寄存器:R8~R15,它们都是64位的。
另外还增加了 8 个 128 位 XMM 寄存器。
64 位寄存器与 x86 下的 32 位寄存器兼容,例如 RAX(64位)、EAX(低32)、AX(低16位)、AL(低8位)、AH(8到15位),相应的有R8、R8D、R8W和R8B。
不要在程序中使用如 AH 之类的寄存器,因为在 AMD 的 CPU 上这种用法会与某些指令产生冲突。
通用寄存器(General-Purpose Registers, GPRs),参考 Intel 手册卷 1 3.4.1。
64 位通用寄存器共 16 个(不包含 RIP,Rflags)。在 x64 中关于 RSP、RBP:
RSP :用来进行相对寻址(RIP-relative addressing)来找到堆栈上的参数、局部变量。不像 x86 基于 EBP 寻址。RBP :仍可做 Base Frame Point,但是常被用来当通用寄存器使用(GPRs)。
2.2 易失/非易失寄存器 易失寄存器 是由调用方假想的临时寄存器,并要在调用过程中销毁。 非易失寄存器需要在整个函数调用过程中保留其值,并且一旦使用,则必须由被调用方保存 (所以常会看到堆栈中保存 rbp, rdi)。
易变寄存器:RAX, RCX, RDX, R8-R11
非易变寄存器:RBP, RBX, RSI, RDI, R12-R15
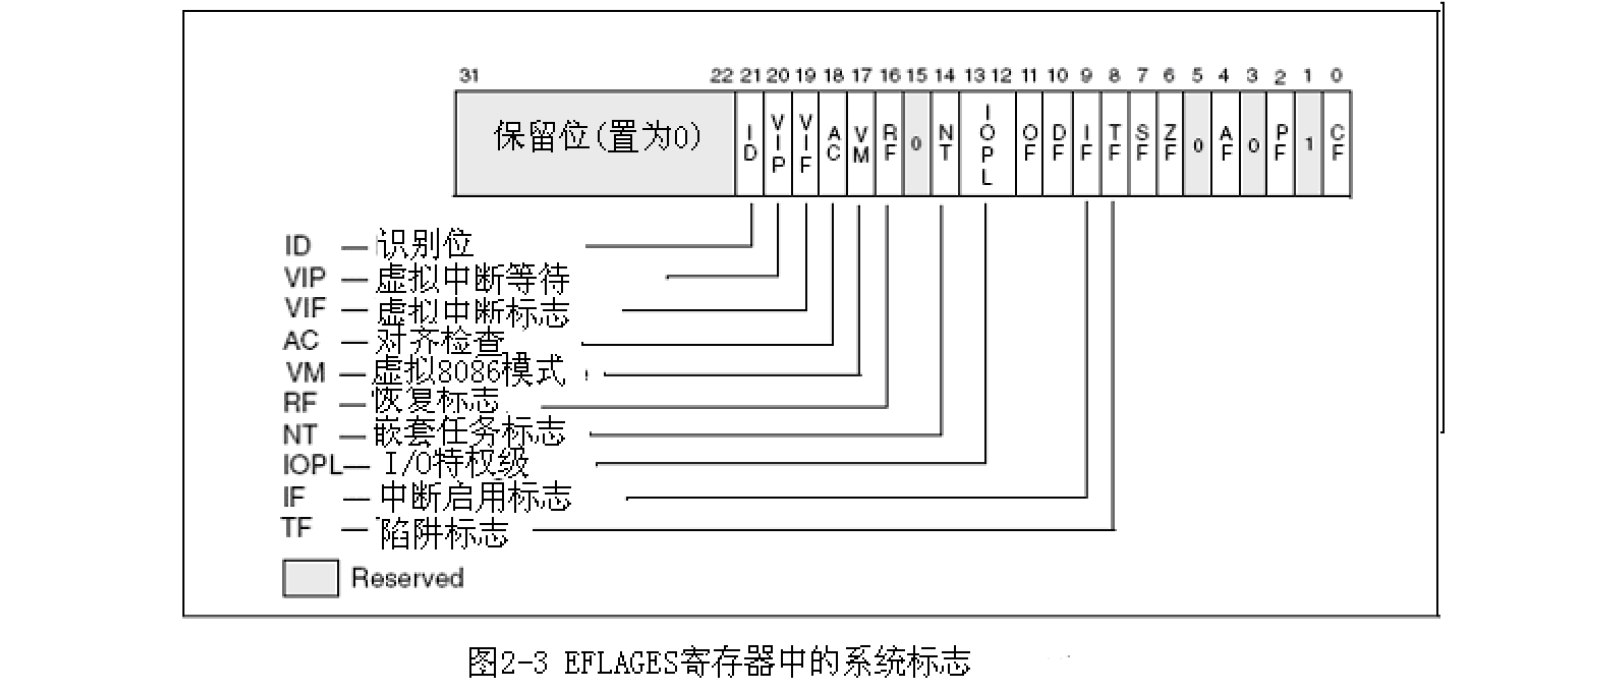
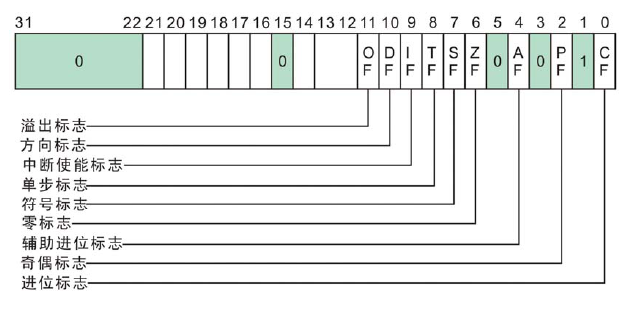
2.3 RFLAGS 在 x64 中,将 EFLAGS 扩展成 64 位,但是高 32 位保留。所以对于 x64 来说,RFLAGS 和 EFLAGS 是一样的。
RFLAGS 的位受算术/逻辑运算影响,同时 RFLAGS 的位也影响 CPU 的执行。如 TF 置位时 CPU 单步运行。
具体标识为可看 Intel 手册卷 1 3.4.3 和 EFLAGS寄存器(标志寄存器) 。
将 EFLAG 移入和移出堆栈或 EAX 寄存器:LAHF、SAHF、PUSHF、PUSHFD、PUSHFQ、POPF、POPFD 和 POPFQ。
修改 EFLAG 标识位的指令:BT、BTS、BTR 和 BTC 。
IA-32e 模式下,不允许修改 VM、NT 位 (Intel 手册卷3 2.3.1)。
下面罗列一些与算术、逻辑运算相关的位:
标志位
位置
解释
CF(Carry flag)
Bit 0
进位标志。负数 计算溢出时置位。mov al, 0FFh ; CF = 0add al, 1 ; CF = 1
OF(Overflow flag )
Bit 11
溢出标志。操作发生溢出,导致符号改变(仅对有符号数 )。mov cl, 07Fh ; OF = 0add cl, 1 ; OF = 1
ZF(Zero flag)
Bit 6
零标志。当算术或逻辑运算的结果为零时设置该标志。 这也可以使用比较指令进行设置。
SF(Sign flag)
Bit 7
负数符号标志。运算结果是负数 时置 1。
3 函数操作 函数调用约定:__fastcall。
调用者在堆栈中会给 RCX、RDX、R8、R9 预留 0x20 字节的空间。
堆栈字节对齐:
x64 prolog 和 epilog :
分配堆栈空间、调用其他函数、保存非易失性寄存器或使用异常处理的每个函数都必须具有 prolog,其地址限制在与相应函数表条目关联的展开数据中进行了描述。 与之对应的是 epilog。有了这两部分,x64 函数和 x86 函数在堆栈平衡的处理上有了较大的区别。x64 的函数内在一开始使用 prolog 来开辟堆栈,在最后时才使用 epilog 来平衡堆栈。而不像是 x86 中的 __cdecl 调用约定那样每次调用完函数立即要平衡堆栈。x64 是在函数最后的 epilog 来平衡堆栈 。
函数结构中典型 prolog 和 epilog 的代码可能是(类似于 x86 异常处理中的安装 SEH):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
prolog: mov [RSP + 8 ], RCX push R15 push R14 push R13 sub RSP, fixed-allocation-size lea R13, 128 [RSP] 函数主体... epilog: add RSP, fixed-allocation-size pop R13 pop R14 pop R15 ret
3.1 调用约定 x64 仅使用 __fastcall 函数调用约定。
x86 使用 __cdecl、__stdcall、__fastcall、__thiscall。
x64 中不管在函数前面声明哪一种调用约定,编译器都只会只用 __fastcall。
Visual C/C++ 编译器支持下列调用约定 。
3.2 堆栈对齐 堆管理器中的分配粒度相对较小:在 32 位系统上是 8 字节,在 64位 系统上是 16 字节 。这部分在《x86 内存管理(二)私有内存-共享内存-物理内存 》堆管理器章节提到过。
在 x64 中,为了保证 CPU 访问内存的高效性,堆栈必须 16 字节对齐 。下一小节 3个参数Release 用实验来进行说明。
3.3 x64 数据类型大小 参考x64 类型和存储布局 。
标量类型
C 数据类型
存储大小(以字节为单位)
建议的对齐方式
INT8char1
Byte
UINT8unsigned char1
Byte
INT16short2
字
UINT16unsigned short2
字
INT32intlong4
双字
UINT32unsigned intunsigned long4
双字
INT64__int648
四字
UINT64unsigned __int648
四字
FP32float4
双字
FP64double8
四字
POINTER*
8
四字
__m64struct __m648
四字
__m128struct __m12816
八倍长字
3.4 堆栈操作 3个参数Debug 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #include <iostream> __int64 Test3Parameters (__int64* arg_1, __int64 arg_2, __int64 arg_3) __int64 iLocal = 0 ; iLocal = *arg_1; return iLocal + arg_2 + arg_3; } int main () __int64 arg = 2 ; arg = Test3Parameters(&arg, 5 , 9 ); printf ("%lld\n" , arg); }
main:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 .text:00000001400118E0 ; =============== S U B R O U T I N E ======================================= .text:00000001400118E0 .text:00000001400118E0 ; Attributes: bp-based frame fpd=0F 0h .text:00000001400118E0 .text:00000001400118E0 sub_1400118E0 proc near ; CODE XREF: sub_1400112C1↑j .text:00000001400118E0 .text:00000001400118E0 var_110 = byte ptr -110 h .text:00000001400118E0 var_F0 = byte ptr -0F 0h .text:00000001400118E0 var_E8 = qword ptr -0E8 h .text:00000001400118E0 var_18 = qword ptr -18 h .text:00000001400118E0 .text:00000001400118E0 ; __unwind { .text:00000001400118E0 push rbp .text:00000001400118E2 push rdi .text:00000001400118E3 sub rsp, 108 h .text:00000001400118 EA lea rbp, [rsp+20 h] .text:00000001400118 EF lea rdi, [rsp+110 h+var_F0] .text:00000001400118F 4 mov ecx, 0 Ah .text:00000001400118F 9 mov eax, 0 CCCCCCCCh .text:00000001400118F E rep stosd .text:0000000140011900 mov rax, cs:__security_cookie .text:0000000140011907 xor rax, rbp .text:000000014001190 A mov [rbp+0F 0h+var_18], rax .text:0000000140011911 lea rcx, unk_140023035 .text:0000000140011918 call sub_1400113CF .text:000000014001191 D mov [rbp+0F 0h+var_E8], 2 .text:0000000140011925 mov r8d, 9 .text:000000014001192B mov edx, 5 .text:0000000140011930 lea rcx, [rbp+0F 0h+var_E8] .text:0000000140011934 call sub_140011136 .text:0000000140011939 mov [rbp+0F 0h+var_E8], rax .text:000000014001193 D mov rdx, [rbp+0F 0h+var_E8] .text:0000000140011941 lea rcx, aLld ; "%lld\n" .text:0000000140011948 call sub_14001143D .text:000000014001194 D xor eax, eax .text:000000014001194F mov edi, eax .text:0000000140011951 lea rcx, [rbp+0F 0h+var_110] .text:0000000140011955 lea rdx, unk_14001B850 .text:000000014001195 C call sub_14001135C .text:0000000140011961 mov eax, edi .text:0000000140011963 mov rcx, [rbp+0F 0h+var_18] .text:000000014001196 A xor rcx, rbp ; StackCookie .text:000000014001196 D call j___security_check_cookie .text:0000000140011972 lea rsp, [rbp+0E8 h] .text:0000000140011979 pop rdi .text:000000014001197 A pop rbp .text:000000014001197B retn .text:000000014001197B ; } .text:000000014001197B sub_1400118E0 endp
子函数:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 .text:0000000140011870 ; =============== S U B R O U T I N E ======================================= .text:0000000140011870 .text:0000000140011870 ; Attributes: bp-based frame fpd=0F 0h .text:0000000140011870 .text:0000000140011870 sub_140011870 proc near ; CODE XREF: .text:0000000140011087 ↑j .text:0000000140011870 ; sub_140011136↑j .text:0000000140011870 .text:0000000140011870 var_E8 = qword ptr -0E8 h .text:0000000140011870 arg_0 = qword ptr 10 h .text:0000000140011870 arg_8 = qword ptr 18 h .text:0000000140011870 arg_10 = qword ptr 20 h .text:0000000140011870 .text:0000000140011870 mov [rsp-8 +arg_10], r8 .text:0000000140011875 mov [rsp-8 +arg_8], rdx .text:000000014001187 A mov [rsp-8 +arg_0], rcx .text:000000014001187F push rbp .text:0000000140011880 push rdi .text:0000000140011881 sub rsp, 108 h .text:0000000140011888 lea rbp, [rsp+20 h] .text:000000014001188 D lea rcx, unk_140023035 .text:0000000140011894 call sub_1400113CF .text:0000000140011899 mov [rbp+0F 0h+var_E8], 0 .text:00000001400118 A1 mov rax, [rbp+0F 0h+arg_0] .text:00000001400118 A8 mov rax, [rax] .text:00000001400118 AB mov [rbp+0F 0h+var_E8], rax .text:00000001400118 AF mov rax, [rbp+0F 0h+arg_8] .text:00000001400118B 6 mov rcx, [rbp+0F 0h+var_E8] .text:00000001400118B A add rcx, rax .text:00000001400118B D mov rax, rcx .text:00000001400118 C0 add rax, [rbp+0F 0h+arg_10] .text:00000001400118 C7 lea rsp, [rbp+0E8 h] .text:00000001400118 CE pop rdi .text:00000001400118 CF pop rbp .text:00000001400118 D0 retn .text:00000001400118 D0 sub_140011870 endp
3 个参数Release main
1 2 3 4 5 6 7 8 9 10 11 12 13 .text:0000000140001070 ; =============== S U B R O U T I N E ======================================= .text:0000000140001070 .text:0000000140001070 .text:0000000140001070 sub_140001070 proc near ; CODE XREF: sub_1400011A4+107 ↓p .text:0000000140001070 ; DATA XREF: .pdata:000000014000400 C↓o .text:0000000140001070 sub rsp, 28 h .text:0000000140001074 mov edx, 10 h .text:0000000140001079 lea rcx, aLld ; "%lld\n" .text:0000000140001080 call sub_140001010 .text:0000000140001085 xor eax, eax .text:0000000140001087 add rsp, 28 h .text:000000014000108B retn .text:000000014000108B sub_140001070 endp
Release 版本直接将答案计算好了。
注意 :这里的 sub rsp, 28h 除了给 rcx,rdx,r8,r9 预留 0x20 字节大小的空间外,还多出来了 0x8 字节,为什么?
答案:为了和返回地址构成 16(0x10) 字节对齐 !
观察此时的堆栈情况:
6个参数Debug 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #include <iostream> __int64 Test3Parameters (__int64* arg_1, __int64 arg_2, __int64 arg_3, __int64 arg_4, __int64 arg_5, __int64 arg_6) __int64 iLocal = 0 ; iLocal = *arg_1; return iLocal + arg_2 + arg_3 - arg_4 + arg_5 + arg_6; } int main () __int64 arg = 2 ; arg = Test3Parameters(&arg, 3 , 4 , 5 , 6 , 8 ); printf ("%lld\n" , arg); }
main
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 .text:0000000140011 AC0 ; =============== S U B R O U T I N E ======================================= .text:0000000140011 AC0 .text:0000000140011 AC0 ; Attributes: bp-based frame fpd=0F 0h .text:0000000140011 AC0 .text:0000000140011 AC0 sub_140011AC0 proc near ; CODE XREF: sub_1400112C1↑j .text:0000000140011 AC0 .text:0000000140011 AC0 var_120 = byte ptr -120 h .text:0000000140011 AC0 var_100 = qword ptr -100 h .text:0000000140011 AC0 var_F8 = qword ptr -0F 8h .text:0000000140011 AC0 var_F0 = byte ptr -0F 0h .text:0000000140011 AC0 var_E8 = qword ptr -0E8 h .text:0000000140011 AC0 var_18 = qword ptr -18 h .text:0000000140011 AC0 .text:0000000140011 AC0 ; __unwind { .text:0000000140011 AC0 push rbp .text:0000000140011 AC2 push rdi .text:0000000140011 AC3 sub rsp, 118 h .text:0000000140011 ACA lea rbp, [rsp+30 h] .text:0000000140011 ACF lea rdi, [rsp+120 h+var_F0] .text:0000000140011 AD4 mov ecx, 0 Ah .text:0000000140011 AD9 mov eax, 0 CCCCCCCCh .text:0000000140011 ADE rep stosd .text:0000000140011 AE0 mov rax, cs:__security_cookie .text:0000000140011 AE7 xor rax, rbp .text:0000000140011 AEA mov [rbp+0F 0h+var_18], rax .text:0000000140011 AF1 lea rcx, unk_140023035 .text:0000000140011 AF8 call sub_1400113CF .text:0000000140011 AFD mov [rbp+0F 0h+var_E8], 2 .text:0000000140011B 05 mov [rsp+120 h+var_F8], 8 .text:0000000140011B 0E mov [rsp+120 h+var_100], 6 .text:0000000140011B 17 mov r9d, 5 .text:0000000140011B 1D mov r8d, 4 .text:0000000140011B 23 mov edx, 3 .text:0000000140011B 28 lea rcx, [rbp+0F 0h+var_E8] .text:0000000140011B 2C call sub_14001144C .text:0000000140011B 31 mov [rbp+0F 0h+var_E8], rax .text:0000000140011B 35 mov rdx, [rbp+0F 0h+var_E8] .text:0000000140011B 39 lea rcx, aLld ; "%lld\n" .text:0000000140011B 40 call sub_14001143D .text:0000000140011B 45 xor eax, eax .text:0000000140011B 47 mov edi, eax .text:0000000140011B 49 lea rcx, [rbp+0F 0h+var_120] .text:0000000140011B 4D lea rdx, unk_14001B850 .text:0000000140011B 54 call sub_14001135C .text:0000000140011B 59 mov eax, edi .text:0000000140011B 5B mov rcx, [rbp+0F 0h+var_18] .text:0000000140011B 62 xor rcx, rbp ; StackCookie .text:0000000140011B 65 call j___security_check_cookie .text:0000000140011B 6A lea rsp, [rbp+0E8 h] .text:0000000140011B 71 pop rdi .text:0000000140011B 72 pop rbp .text:0000000140011B 73 retn .text:0000000140011B 73 ; } .text:0000000140011B 73 sub_140011AC0 endp
子函数
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 .text:0000000140011 A40 sub_140011A40 proc near ; CODE XREF: sub_14001144C↑j .text:0000000140011 A40 .text:0000000140011 A40 var_E8 = qword ptr -0E8 h .text:0000000140011 A40 arg_0 = qword ptr 10 h .text:0000000140011 A40 arg_8 = qword ptr 18 h .text:0000000140011 A40 arg_10 = qword ptr 20 h .text:0000000140011 A40 arg_18 = qword ptr 28 h .text:0000000140011 A40 arg_20 = qword ptr 30 h .text:0000000140011 A40 arg_28 = qword ptr 38 h .text:0000000140011 A40 .text:0000000140011 A40 mov [rsp-8 +arg_18], r9 .text:0000000140011 A45 mov [rsp-8 +arg_10], r8 .text:0000000140011 A4A mov [rsp-8 +arg_8], rdx .text:0000000140011 A4F mov [rsp-8 +arg_0], rcx .text:0000000140011 A54 push rbp .text:0000000140011 A55 push rdi .text:0000000140011 A56 sub rsp, 108 h .text:0000000140011 A5D lea rbp, [rsp+20 h] .text:0000000140011 A62 lea rcx, unk_140023035 .text:0000000140011 A69 call sub_1400113CF .text:0000000140011 A6E mov [rbp+0F 0h+var_E8], 0 .text:0000000140011 A76 mov rax, [rbp+0F 0h+arg_0] .text:0000000140011 A7D mov rax, [rax] .text:0000000140011 A80 mov [rbp+0F 0h+var_E8], rax .text:0000000140011 A84 mov rax, [rbp+0F 0h+arg_8] .text:0000000140011 A8B mov rcx, [rbp+0F 0h+var_E8] .text:0000000140011 A8F add rcx, rax .text:0000000140011 A92 mov rax, rcx .text:0000000140011 A95 add rax, [rbp+0F 0h+arg_10] .text:0000000140011 A9C sub rax, [rbp+0F 0h+arg_18] .text:0000000140011 AA3 add rax, [rbp+0F 0h+arg_20] .text:0000000140011 AAA add rax, [rbp+0F 0h+arg_28] .text:0000000140011 AB1 lea rsp, [rbp+0E8 h] .text:0000000140011 AB8 pop rdi .text:0000000140011 AB9 pop rbp .text:0000000140011 ABA retn .text:0000000140011 ABA sub_140011A40 endp
6个参数Release main
1 2 3 4 5 6 7 8 9 10 .text:0000000140001070 sub_140001070 proc near ; CODE XREF: sub_1400011A4+107 ↓p .text:0000000140001070 ; DATA XREF: .pdata:000000014000400 C↓o .text:0000000140001070 sub rsp, 28 h .text:0000000140001074 mov edx, 12 h .text:0000000140001079 lea rcx, aLld ; "%lld\n" .text:0000000140001080 call sub_140001010 .text:0000000140001085 xor eax, eax .text:0000000140001087 add rsp, 28 h .text:000000014000108B retn .text:000000014000108B sub_140001070 endp
4 其他知识点 4.0 x64寄存器使用注意
寄存器的使用。
对 32 位寄存器的写操作 (包括运算结果),会自动对相应的 64 位寄存器的高 32 位清 0 。
但是对 16 位的寄存器进行操作,是不会影响高位的,不会自动清零。
如下指令:
1 2 3 4 5 6 7 8 9 10 11 12 13 xor eax, eax;xor rax, rax;mov rbx, 0xFFEEDDCCAABB2230 ; mov ebx, 0x1 ; mov rbx, 0xFFEEDDCCAABB2230 ; mov bx, 1 ;
立即数的使用。
立即数的使用,优先使用 32 位寄存器(因为 64 位指令较长)。如操作数位宽不超过 32 位,硬尽量使用 32 位的寄存器。
参数长度不超过4个字节的时候,分别使用32位的寄存器进行传参,这个是编译器做的处理,长度足够存储数据的情况下,优先使用32位寄存器,因为操作64位寄存器(如MOV指令)的指令占4个字节,多一个48前缀指令,说明操作数是64位的,而32位寄存器只需要3个字节的指令长度《x64的一些特性 》
x64 指令限制。
push/pop 的操作数只能是 32 位,无法操作 64 位操作数。pushad/popad 在 x64 中就完全不支持。但是可以使用 pushfq/popfq。
如下:
1
2
3
4
5
6
7
push 0x123456789 ; mov rax, 0x123456789 ; push rax; mov qword ptr ds:[rax], 0x123456789 ; mov qword ptr ds:[rax], 0x12345678 ;
访问 RIP-2GB~RIP+2GB 范围的地址都会使用 RIP-Relative(这里的 RIP 为当前指令的地址)来进行寻址。
如48:8B05 前缀使用 RIP-Relative(这里的 RIP 为当前指令的地址):x64 中,如果要访问的内存地址范围在 RIP-2GB~RIP+2GB
1 2 3 4 5 6 00007F F92E0D0F20 | 48 :8B 05 00000000 | mov rax,qword ptr ds:[7F F92E0D0F27] 00007F F92E0D0F27 | 0048 85 | add byte ptr ds:[rax-7B ],cl 00007F F92E0D0F2A | 48 :8B 05 01000000 | mov rax,qword ptr ds:[7F F92E0D0F32] 00007F F92E0D0F31 | 81 C1 F0040000 | add ecx,4F 0
jmp 硬编码。
可看 Intel 手册卷1
EB:jmp rel8,Jump short,RIP = RIP+当前指令长度 +(FF~7F)。
E9:jmp rel16,在 x64 下不支持。
E9:jmp rel32,Jump near,RIP = RIP+当前指令长度 +(-2G~2G)。
64位下的inline Hook 、R3 下常用Hook技术 。
在 x86 CPU 上,FS 段寄存器指向线程环境块 (TEB) 和处理器控制区域 (KPCR),但在 x64 上,GS 寄存器在用户模式下指向 TEB,在内核中指向 KPCR 的新模式。然而,当运行 WOW64 应用程序(即 x64 系统上的 32 位应用程序)时,FS 寄存器继续指向 32 位版本的 TEB。x64上的陷阱帧结构体nt!_KTRAP_FRAME不包含非易失性寄存器的有效内容。如果打算修改非易失性寄存器,X64函数的prolog会保存非易失性寄存器的值。调试器始终可以从堆栈中提取这些非易失性寄存器的保存值,而不必从陷阱帧中获取它们。 在x64上的内核模式调试期间,.trap命令的输出会打印一条注释,突出显示从陷阱中检索到的所有寄存器的值可能不准确的事实,如下所示。此规则有例外,例如,为用户到内核模式转换生成的陷阱帧确实包含所有寄存器的正确值。
内存优先使用相对偏移寻址,直接寻址指令较少。
4.1 ASCII ASCII 表的 Github 项目 :
4.2 小端存储
4.3 汇编编译器
nasm, fasm, yas:免费开源汇编编译器,都是使用 Intel 语法。
yasm 在 nasm 基础上开发,使用 Intel 语法。
masm:微软发布的汇编编译器,已集合在 VS 中,使用 Intel 语法。
gas:linux 免费开源汇编编译器,使用 AT&T 语法。
4.4 整数取值范围 在计算机处理中,整数会区分 signed(有符号数)和 unsigned(无符号数)两种情 况,数值的 MSB 值被作为符号位。每个数值类型有自己的取值范围,如下所示。
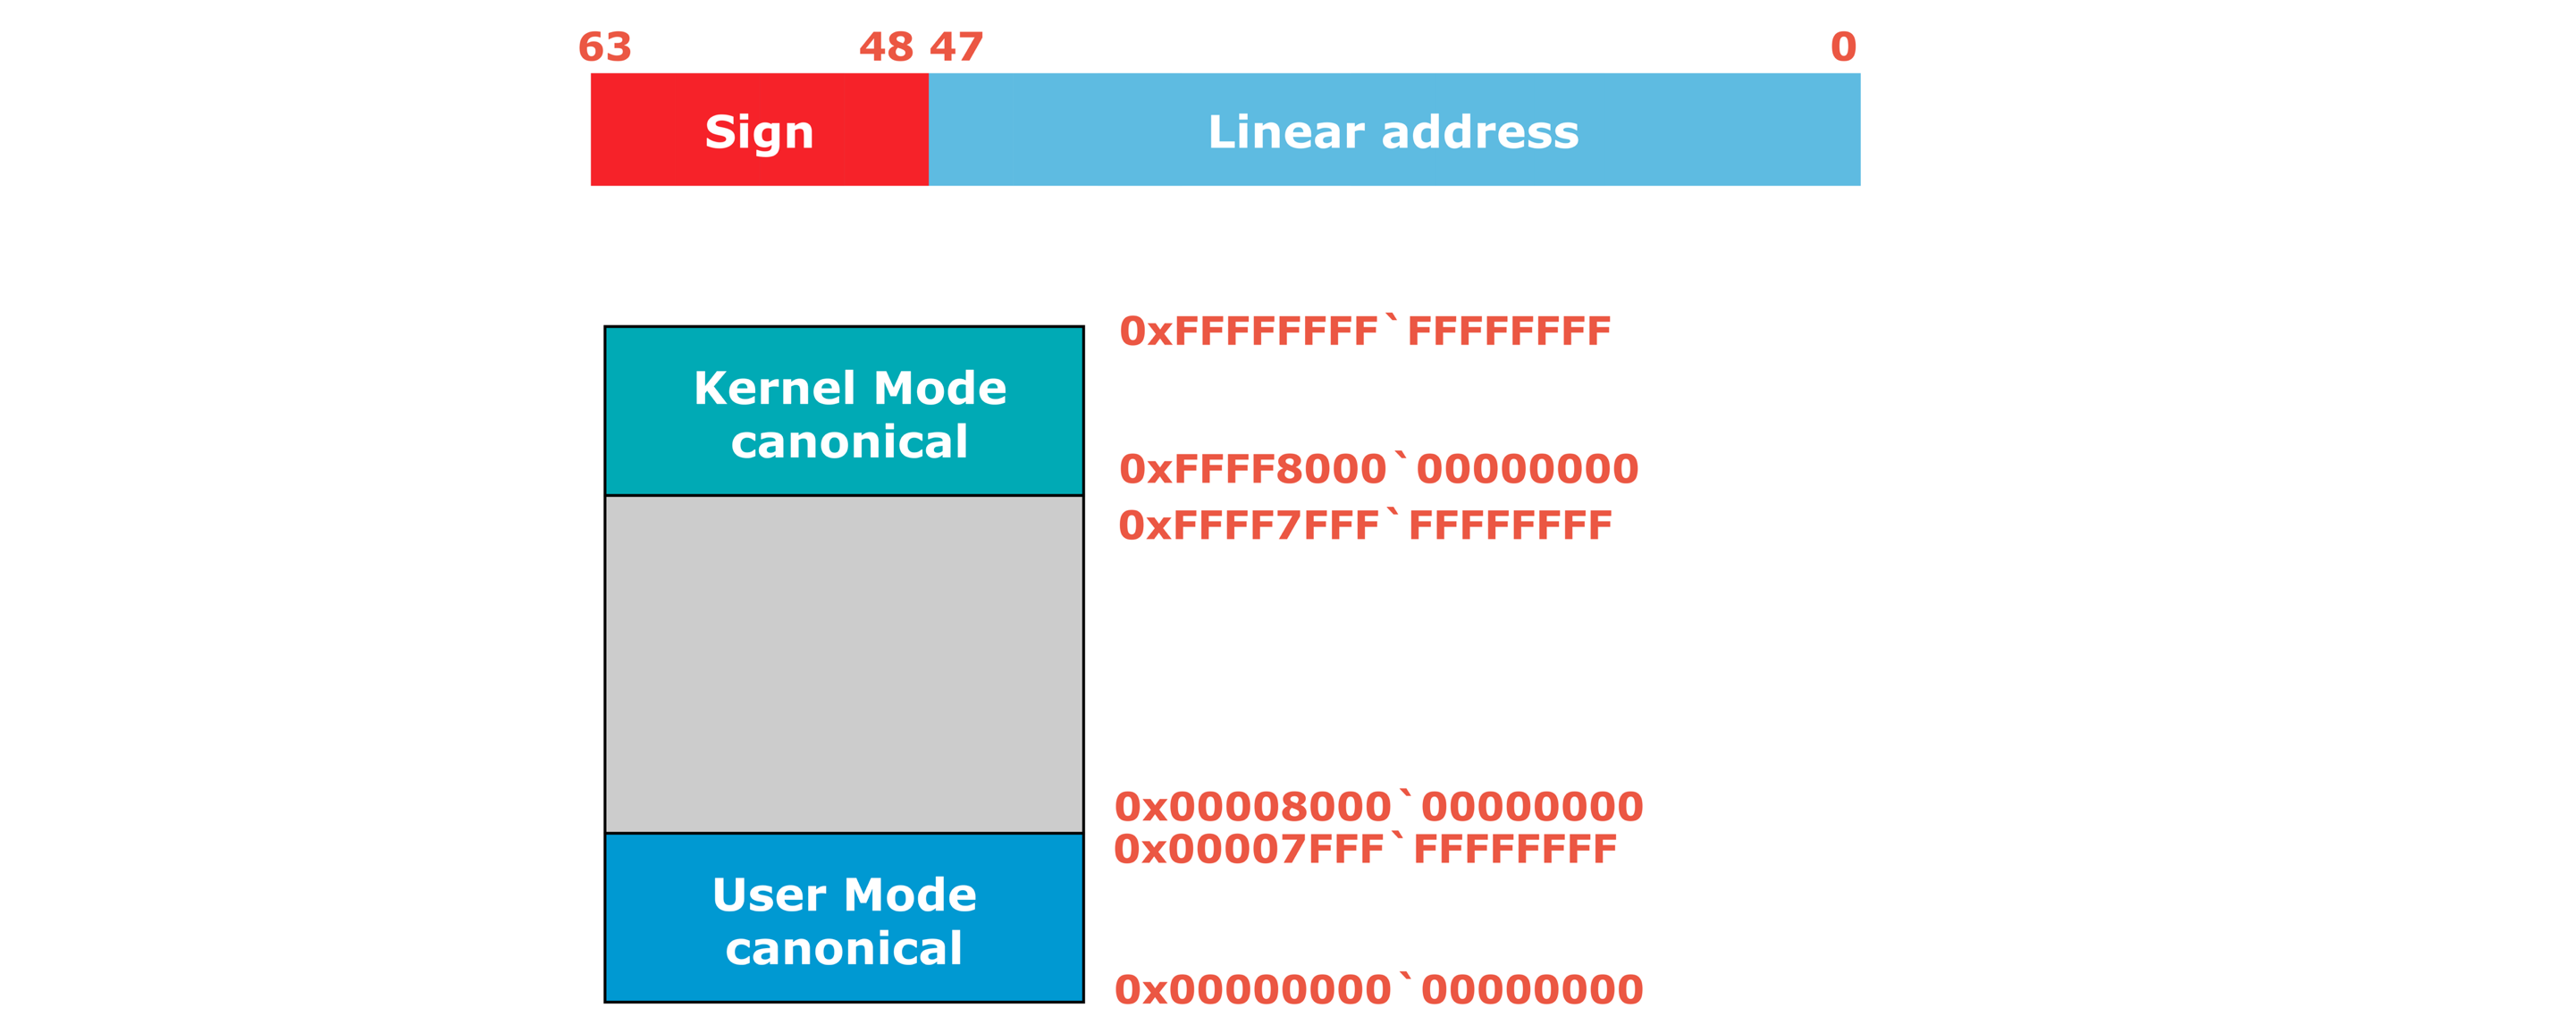
4.5 x64地址范围 x64 体系里只实现了48 位的虚拟地址,高16 位被用做符号 扩展。这高 16 位必须全是 0 或者全是 1,这种形式的地址被称为 canonical 地址。
处理器会对软件上的 non-canonical 地址形式进行检查,程序中访问了non-canonical 地址会产生 #GP 异常。
4.6 线性地址 在 x86 保护模式下:
逻辑地址:0x23:00400000。0x23 为段选择子,0x00400000 为段偏移。
线性地址:在分页模式下使用,MMU 将逻辑地址可转换为线性地址。由于除了 FS 其余段基址为 0,所以逻辑地址等于线性地址。
虚拟地址:逻辑地址和线性地址都是虚拟地址。
在 x64 下,只有线性地址(虚拟地址)。
实模式、保护模式下的逻辑地址:$segment:offset$。
实模式:$linear\_address = segment << 4 + offset$
保护模式:$linear\_address = segment\_base + offset$
x64:$linear\_address = offset$
在 x64 下,除了 FS 与GS 段可以使用非 0 值的 base 外,其余的 ES、 CS、 DS 及 SS 段的 base 值强制为 0 值。因此,实际上线性地址就等于代码中的 offset 值。
4.7 RIP-Relative 4.8 内存对齐
x86:8 字节对齐,ESP & 0xFFFFFFF8。
x64:16 字节对齐,RSP & 0xFFFFFFFF'FFFFFFF0。
5 64 位模式的指令 5.0 REX prefix REX prefix 是不定值,它的取值范围是:0x40 - 0x4F (共 16 个),高 4 位固定为 4,低 4 位为变化值。
7
6
5
4
3
2
1
0
0
1
0
0
W
R
X
B
低 4 位表述为:
当默认操作数大小为 32 位是, REX.W = 1,即前缀取值为 0x48 时,则会将操作数大小改为 64 位。
5.1 操作数大小(operand Size) 在 64 位模式下,仅有少数指令的默认操作数是 64 位,大多数指令的默认操作数仍是 32 位的。在默认操作数为 32 位的指令中,如果要将其变成 64 位的操作数必须使用 REX prefix。
在 64 位模式下指令可以使用 16 位的操作数,但是:如果指令默认操作数大小是 64 位时,不能通过指令前缀来将操作数变成 32 位,但是可以变成 16 位 。
示例一:默认操作数大小 64 位
在 x64 dbg 调试器下,push 指令默认操作数大小为 64 位,如果要使用 16 位操作数需加前缀 0x66。不支持 32 位操作数。
示例二:默认操作数大小 32 位
在 x64 dbg 调试器下,mov 指令默认操作数大小为 32 位,如果要使用 16 位操作数需加前缀 0x66。使用 64 位操作数需加前缀 0x48。
默认操作数为64 位的指令
依赖于 RIP 指针的 near branch(近程分支)指令。
依赖于 RSP 指针的 stack 操作指令。
5.2 64 位模式无效指令
5.3 寻址地址大小(operand address size)
在 64 位模式下,指令的 default operand address size(默认地址大小)是 64 位的,指的是操作数的寻址大小。
在 64 位模式下,指令的 default operand size(默认操作数大小)为 64 位或 32 位。
指令的默认地址大小同样由 CS.L 和 CS.D 标志决定。
如下,在 64-bit 模式下,使用 32 位 寻址时会使用 0x67 指令前缀:
1
2
00007F FA2C7E0960 | 6748 :8B 01 | mov rax,qword ptr ds:[ecx] 00007F FA2C7E0964 | 67 :FF30 | push qword ptr ds:[eax]